전화 한 통으로 인지 건강의 이상 신호를 감지할 수 있다면
“어르신, 요즘은 어떻게 지내세요?”
우리가 나누는 일상적인 대화 속에는 안부 이상의 정보가 담겨 있습니다. 무엇을 말하는지, 그리고 어떻게 말하는지에는 인지 건강 상태가 미묘하게 드러나기 때문입니다.
치매는 세계보건기구(WHO) 기준(2021년) 전 세계 5,700만 명이 겪고 있는 질환으로, 조기에 발견할수록 적절한 개입으로 진행을 늦출 가능성이 커집니다. 하지만 인지 저하의 조기 신호는 두드러지지 않아 일상에서 지나치기 쉽습니다. 인지 저하가 의심되면 뇌 영상 촬영이나 최근 보고되는 혈액 검사 같은 정밀 검사를 받게 되는데, 모두 의료기관 방문이 전제되고 비용 부담도 큽니다. 만약 이런 검사 단계에 이르기 전에, 전화 속 목소리만으로 인지 저하의 징후를 수시로 살필 수 있다면 어떨까요?
네이버클라우드가 이 질문에 답하기 위해 이어온 연구에서 나온 논문 두 편이 음성 분야를 대표하는 국제 학회 Interspeech 2026에 채택되었습니다. 두 연구는 서로 다른 접근을 택했지만, 같은 공개 데이터셋으로 평가했을 때 둘 다 발표 시점 기준 기존 최고 성능을 넘어 똑같은 점수에 도달했습니다. 연구 ①은 소리(음향)와 언어를 따로 분석한 뒤 결합하고, 연구 ②는 모든 단서를 대규모 언어 모델(LLM) 하나에 맡깁니다. 두 연구가 각각 어떤 방식으로 목소리 속 인지 건강의 신호를 읽어내는지 소개해 드리겠습니다.
목소리가 알려주는 두 가지 단서: 무엇을 말하는가, 어떻게 말하는가
인지 기능이 저하되면 말에는 크게 두 종류의 변화가 나타납니다.
첫 번째는 언어적(linguistic) 변화입니다. 하고 싶은 단어가 잘 떠오르지 않아 “그… 왜 있잖아, 그거”처럼 돌려 말하거나, “아니, 그게 아니라”처럼 말하다가 스스로 고쳐 말하는 일이 잦아지고, 사용하는 어휘가 단조로워지며 문장 구조가 단순해지는 식입니다.
두 번째는 음향적(acoustic) 변화입니다. 말과 말 사이의 머뭇거림이 길어지고, 발화 속도가 느려지는 등 ‘말의 내용’이 아니라 ‘말하는 방식’ 자체가 달라집니다.
두 연구는 이 두 변화를 모델이 읽을 수 있는 형태로 만들었습니다. 연구 ①은 언어적 변화를 잡기 위해 LLM이 각 문장을 읽고 어휘의 다양성, 문법적 완성도, 유창성, 그리고 자기 수정이나 불확실 표현의 빈도 같은 문장 내 언어 패턴을 평가하도록 했습니다. 연구 ②는 음향적 변화 가운데 발화 속도와 멈춤을 수치화했는데, 인지 저하가 있는 참가자 그룹은 그렇지 않은 그룹보다 말하는 속도가 느렸습니다(초당 약 2.9단어 대 3.1단어). 또한 0.5초 이상 이어지는 머뭇거림에서 두 그룹의 차이가 가장 뚜렷하게 나타났습니다. 누구나 말하는 중에 아주 잠깐씩은 멈추기 때문에 아주 짧은 멈춤은 두 그룹을 구분하는 데 큰 도움이 되지 않았습니다.
문제는 이 두 단서가 서로 다른 성격의 정보라는 점입니다. 텍스트만 보면 머뭇거림이 사라지고, 소리만 들으면 어휘와 이야기 구성의 변화를 놓치게 됩니다. 두 연구는 각기 다른 접근으로 이 단서들을 함께 활용하는 방법을 제안합니다.
잠깐, 연구에 사용된 ‘그림 설명 과제’란?
두 연구는 ADReSS와 ADReSSo라는 공개 데이터셋으로 성능을 평가했습니다. 치매 연구를 위해 공개된 영어 음성 데이터로, 전 세계 연구팀이 결과를 서로 비교하는 벤치마크 역할을 합니다. 2020년에 공개된 ADReSS는 인지 저하가 있는 참가자와 없는 참가자를 같은 수로 모으고 나이와 성별 분포까지 맞춘 156명 규모의 데이터로, 모델이 나이나 성별이 아니라 말의 차이로 두 그룹을 구분하게 하려는 설계입니다. 이듬해 나온 ADReSSo는 237명으로 규모를 키웠고, 녹음만 제공해 텍스트는 음성 인식으로 직접 받아써야 합니다. 이렇게 구성은 다르지만, 두 데이터셋의 참가자들은 모두 같은 그림을 보고 자유롭게 설명합니다. 부엌에서 아이가 의자 위에 올라가 쿠키 통에 손을 뻗고 있고, 그 옆에서 싱크대의 물이 넘치고 있는 그림으로 ‘쿠키 도둑 그림’이라고 불립니다.
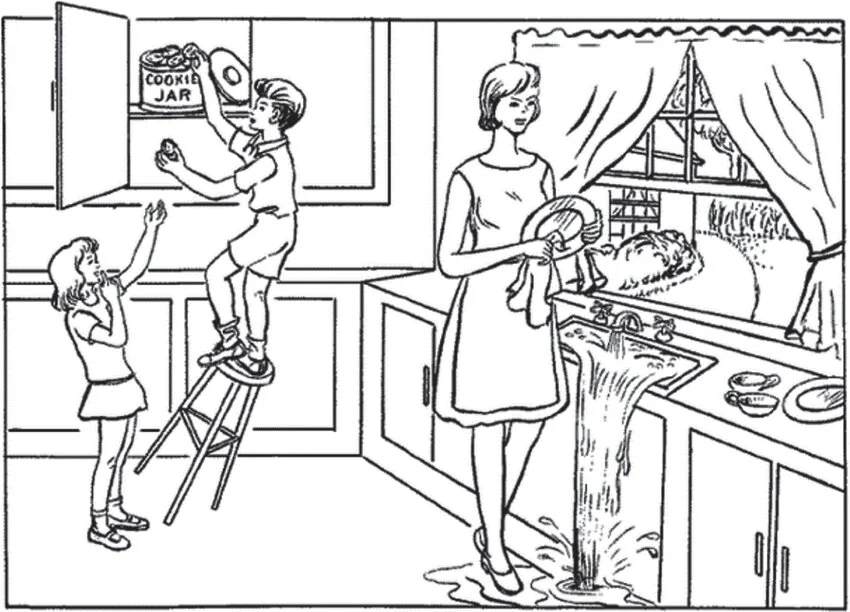
모두가 같은 그림을 설명하기 때문에, ‘무엇을 언급했는지’, ‘어떤 언어 패턴으로 설명하는지’, 그리고 ‘그림의 여러 영역을 얼마나 폭넓게 다루는지’를 참가자끼리 직접 비교할 수 있습니다. 예를 들어 어떤 참가자는 “아이가 의자에 올라가서 쿠키를 꺼내고 있고, 물이 넘치고 있네요.”라고 장면을 짜임새 있게 설명하는 반면, 인지 저하가 있는 참가자는 “음… 이게… 뭐더라… 아이가 있고…”와 같이 확신 없는 표현과 자기 수정이 잦고, 그림의 여러 영역을 두루 살피기보다 일부 영역에 집중하는 경향이 있습니다. 또한 단순히 개별 대상에 대한 언급만을 보는 것이 아니라, 서로 다른 영역의 내용을 얼마나 연결해서 설명하는지도 비교할 수 있습니다.
연구 ① 행간을 듣다: 하나의 음성 인식 모델로 ‘귀’와 ‘언어 감각’을 모두 얻는 방법
첫 번째 논문 「Listening Between the Lines」는 OpenAI가 공개한 음성 인식(ASR) 모델 Whisper를 단순한 받아쓰기 도구로 쓰지 않는다는 발상에서 출발했습니다.
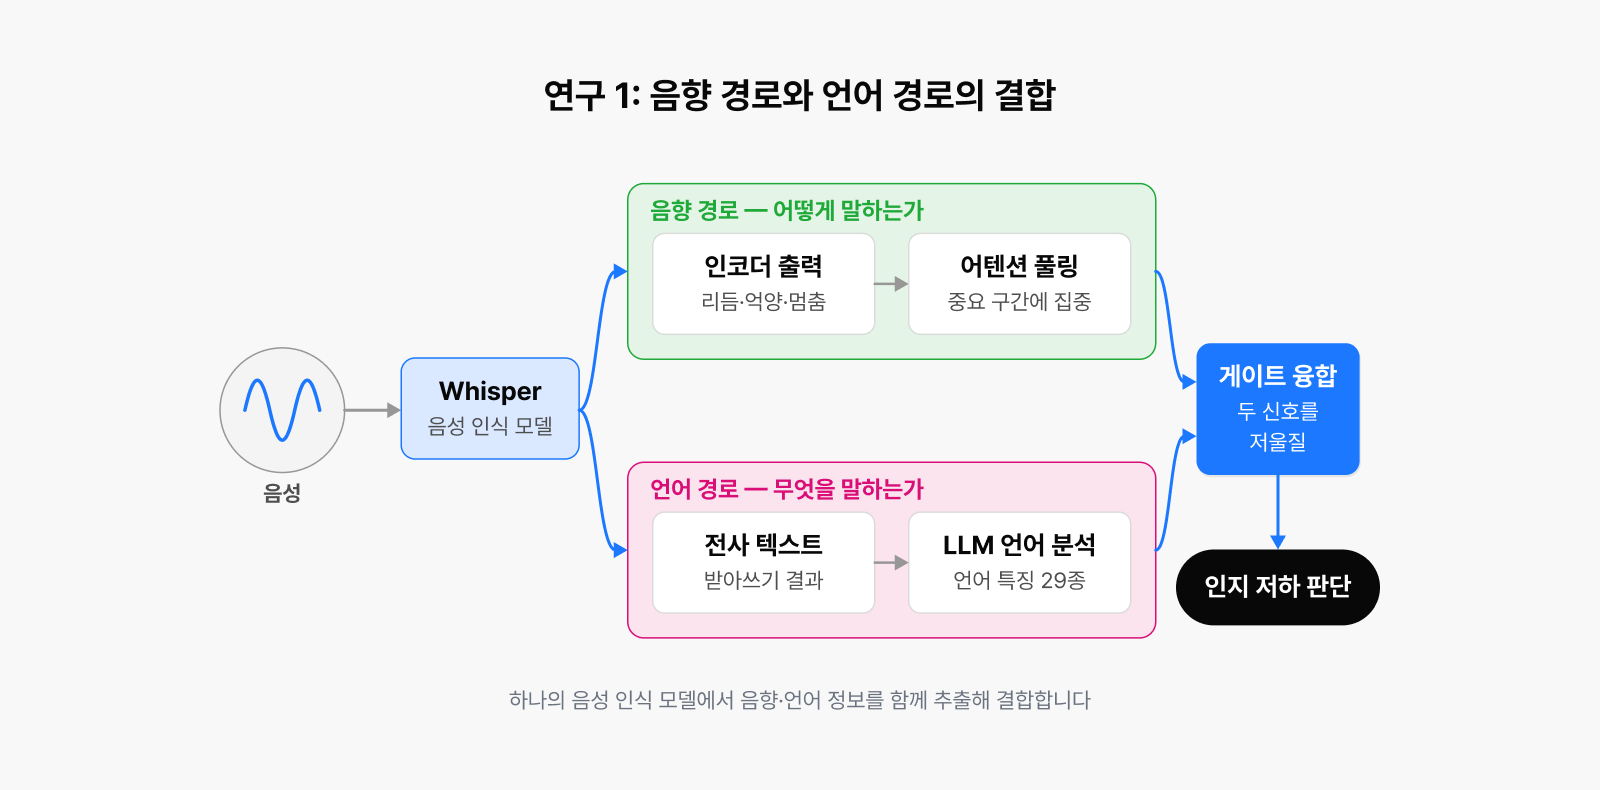
Whisper가 음성을 텍스트로 변환하는 동안, 모델 내부(인코더)에는 최종 텍스트에 남지 않는 정보가 풍부하게 담겨 있습니다. 발음의 명료함, 억양, 리듬, 머뭇거림 같은 음향적 단서들입니다. 즉, 음성을 텍스트로 바꾸는 데서 그치지 않고, 그 과정에서 생기는 비언어적 요소까지 함께 활용하는 것입니다. 이를 위해 이 연구는 음향 경로와 언어 경로를 따로 두고 마지막에 두 신호를 합치는, 세 부분으로 이뤄진 구조를 설계했습니다.
1) 음향 경로: 어디에 집중해서 들을 것인가
Whisper 인코더에서 나온 음향 표현을 시계열 신경망(BiLSTM)으로 처리한 뒤, 어텐션 풀링(attention pooling)으로 요약합니다. 어텐션 풀링은 발화를 잘게 쪼갠 조각마다 ‘분류에 얼마나 중요한가’ 점수를 매기고, 그 점수대로 가중치를 두어 하나의 요약으로 합칩니다. 어느 대목이 중요한지는 사람이 정해 주지 않고 모델이 학습하며 스스로 익히기 때문에, 자동으로 ‘귀를 기울이는’ 장치라고 할 수 있습니다.
2) 언어 경로: LLM이 읽어내는 언어 신호
같은 발화를 받아 적은 텍스트(전사)는 LLM이 분석합니다. 어휘의 다양성, 문법적 완성도, 의미의 일관성, 이야기 전개 방식 등 총 46가지의 해석 가능한 언어 특징을 추출하고, 이 중 분류에 가장 효과적인 29가지를 선별해 사용했습니다.
특히 이 연구에서는 그림 설명을 분석하기 위해 주제 8개로 이뤄진 분류 체계를 LLM으로 자동 구축했습니다. 기존 연구들은 수십 년 전에 사람이 수작업으로 만든 채점 항목에 의존해 왔는데요, LLM이 그림을 보고 사람들이 자연스럽게 묶어서 이야기하는 주제 영역을 스스로 정의하도록 한 것입니다. 이 체계는 아이의 행동, 물이 넘치는 사건 같은 장면 내용 영역 7개와 “음… 뭐더라…” 같은 불확실한 표현과 자기 수정을 담는 ‘메타 담화’ 영역 1개로 구성됩니다.
3) 게이트 융합: 두 신호를 저울질하다
마지막으로 게이트 융합(gated fusion) 네트워크가 음향 신호와 언어 신호를 결합합니다. 게이트 융합은 샘플마다 ‘이번에는 음향 단서가 더 믿을 만한가, 언어 단서가 더 믿을 만한가’를 스스로 판단해 가중치를 조절하는 장치입니다.
결과는 어땠을까요?
정밀도와 재현율을 함께 보는 분류 성능 지표인 F1 점수로 ADReSS에서 89.47%, ADReSSo에서 90.14%를 기록했습니다. 특히 ADReSSo에서는 기존 최고 기록(87.32%)을 넘어서는 결과입니다. ADReSSo 기준으로 음향 정보만 썼을 때는 83.08%, 언어 정보만 썼을 때는 76.06%였으니, 융합이 성능을 각각 7.1%p, 14.1%p 끌어올렸습니다. ‘무엇을 말하는가’와 ‘어떻게 말하는가’가 서로 보완적인 단서라는 가설이 수치로 확인된 셈입니다.
한 가지 흥미로운 발견도 있었습니다. 통계적으로 유의한 특징만 골라 쓴 모델은 78.82%에 그친 반면, 함께 사용했을 때의 분류 성능을 기준으로 선별한 모델은 90.14%를 기록했습니다. 혼자서는 약한 단서라도, 다른 단서와 결합하면 강력한 신호가 될 수 있다는 것이죠.
연구 ② 네 가지 관점을 한 장의 카드로: LLM에 종합 판단을 맡기다
두 번째 논문 「LoRA-Tuned Large Language Models for Dementia Detection via Multi-View Speech-Derived Features」는 질문 하나에서 출발했습니다. “여러 모델과 복잡한 결합 구조 없이, LLM 하나가 이 모든 단서를 한 번에 종합해서 판단할 수는 없을까?”
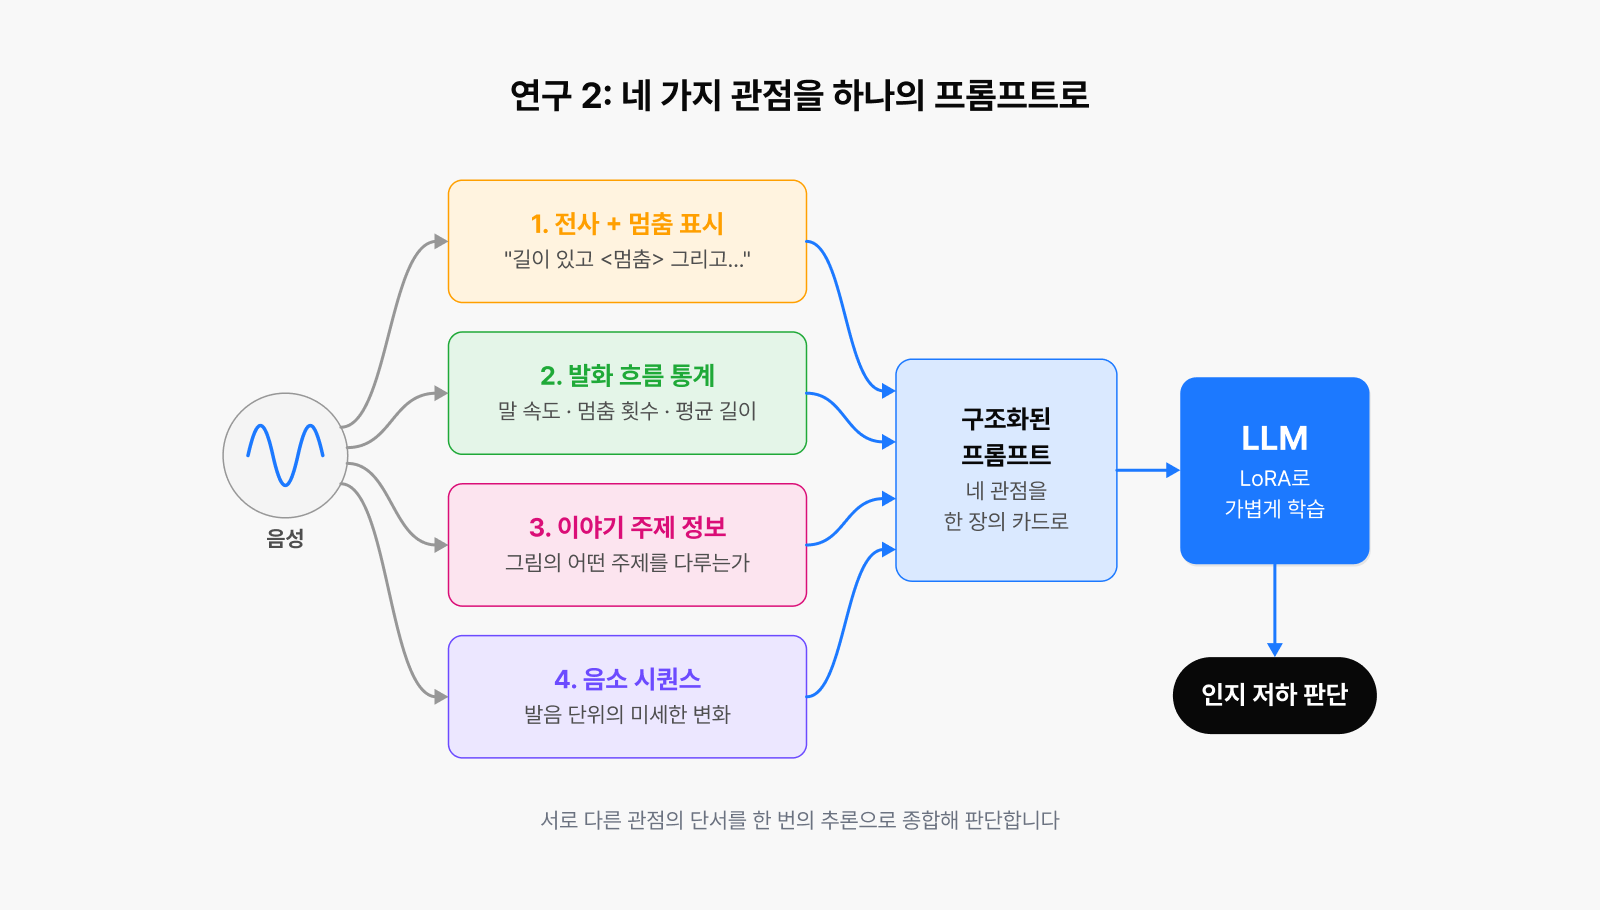
연구 ①을 포함해 지금까지의 접근은 대체로 음향 모델과 텍스트 모델을 따로 학습시킨 뒤 결과를 합치는 방식이었습니다. 이 연구는 반대로, 발화 하나에서 뽑아낸 네 가지 관점(view)의 정보를 하나의 구조화된 프롬프트에 담아 LLM에 통째로 전달합니다.
한 발화를 네 가지 관점으로 읽기
- 전사 텍스트 + 멈춤 표시: 받아쓴 문장 안에 0.5초 이상의 멈춤이 있던 자리를 <멈춤> 토큰으로 표시합니다. “길이 있고 <멈춤> 그리고…”처럼, 텍스트만 봐도 어디서 머뭇거렸는지 알 수 있게 되는 것이죠.
- 발화 흐름 통계: 초당 단어 수, 멈춤 횟수, 평균 멈춤 길이 같은 전체적인 말의 흐름을 숫자로 요약합니다.
- 이야기 주제 정보: 연구 ①에서 소개한 8개 주제 분류 체계로 각 발화가 그림의 어떤 부분을 설명하는지, 혹은 “뭐더라…” 같은 메타 담화에 머무는지 라벨링 합니다.
- 음소 시퀀스: 발음을 소리의 최소 단위인 음소 수준으로 기록합니다. 받아쓴 텍스트에서는 발음이 흔들려도 올바른 단어로 고쳐 적히기 마련인데요. 사람이 불분명한 소리를 문맥으로 보완해 알아듣는 방식에서 영감받은 음소 인식기(HuPER)를 활용해, 흐트러진 발화에서도 안정적으로 음소를 인식하면서 단어에는 드러나지 않는 미세한 조음(입과 혀의 움직임) 변화까지 담아냈습니다.
LoRA: 거대 모델을 ‘가볍게’ 전문가로 만들기
이렇게 만든 프롬프트로 오픈소스 LLM(Qwen3, Gemma3 계열)을 학습시키는데, 이때 LoRA(low-rank adaptation)라는 효율적 학습 기법을 사용합니다. 모델 전체를 다시 학습시키는 대신, 작은 어댑터만 추가로 학습시키는 방식입니다. 집 전체를 리모델링하는 대신 필요한 방에 맞춤 가구만 들여놓는 셈이죠. 치매 음성 데이터는 규모가 크지 않기 때문에, 사전 학습된 모델의 능력을 보존하면서 과제에 맞게 조정하는 이 접근이 특히 효과적입니다.
결과는 어땠을까요?
ADReSSo 벤치마크에서 F1 점수 90.14%를 달성해, 발표 시점까지 보고된 최고 성능(87.32%)을 넘어섰습니다. 연구 ①과 같은 점수인데, 서로 다른 접근으로 같은 결과에 도달한 이 지점은 뒤에서 다시 살펴보겠습니다. 이 연구의 특징은 별도의 음향 인코더나 복잡한 융합 구조 없이, 모델을 한 번 실행하는 것만으로 이 성능을 달성했다는 점입니다.
관점을 하나씩 추가해 본 실험 결과도 인상적입니다. 전사 텍스트만 사용했을 때 81.48%였던 성능이, 앞서 언급한 이야기 주제 정보를 더하자 87.29%로 크게 뛰었습니다. 한 번에 5.81%p가 오른, 가장 큰 기여였습니다. 여기에 발화 흐름 통계(+1.44%p)와 음소 정보(+1.41%p)가 차례로 더해지며 90.14%에 도달했습니다. ‘발화가 그림의 어떤 주제를 다루는가’라는 담화 수준의 단서가 치매 탐지에 얼마나 중요한지 보여주는 결과입니다. 또한 모델 크기, 즉 파라미터 수가 약 40억 개(4B)에서 140억 개(14B)로 커질수록 성능이 일관되게 향상되면서도, 작은 모델도 기존 시스템들과 경쟁력 있는 성능을 유지했습니다.
두 연구가 함께 그리는 그림
한 연구팀이 제안한, 구조가 전혀 다른 두 접근이 같은 벤치마크(ADReSSo)에서 나란히 90.14%에 도달했습니다. 하나는 두 갈래의 신경망을 게이트 융합으로 결합한 모델이고, 다른 하나는 네 가지 관점을 프롬프트에 담아 LLM 하나에 맡긴 모델입니다.
이 일치가 시사하는 바는 성능의 열쇠가 특정한 모델 구조보다는 ‘무엇을 말하는가’와 ‘어떻게 말하는가’를 함께 읽어내는 데 있다는 점입니다. 실제로 두 연구의 실험 모두에서 단서를 하나씩 더할 때마다 성능이 일관되게 상승했고, 한쪽 단서만 사용한 모델은 뚜렷한 격차로 뒤처졌습니다.
또 하나의 공통점은 LLM이 음성 기반 인지 건강 분석의 유용한 도구가 될 수 있다는 점입니다. 수작업 채점 기준을 대체하는 주제 분류 체계를 만들고, 해석 가능한 언어 특징을 뽑아내고, 이질적인 단서들을 하나의 추론으로 종합하는 역할까지, 두 연구 모두에서 LLM이 핵심적인 역할을 수행했습니다.
물론 이번 연구는 영어 공개 데이터셋 기반의 검증이라는 한계가 있습니다. 공통 기준에서 방법의 유효성을 먼저 확인하고 실제 환경 검증은 별도 단계로 이어가는 것이 일반적인 연구 순서입니다. 연구팀은 다음 단계로 다국어 벤치마크 확장과 함께, 그림 설명 한 가지가 아닌 실제 서비스에서 오가는 다양한 대화 주제에서도 성능을 확보하는 연구를 이어갈 계획입니다.
인지 건강 연구를 통한 다음 걸음
이번 두 논문은 호주 시드니에서 열린 Interspeech 2026에서 발표되었습니다.
네이버클라우드는 CLOVA CareCall을 통해 AI가 어르신께 전화를 걸어 안부를 묻는 서비스를 제공해 왔습니다. 이번 연구는 이 대화가 단순한 안부 확인을 넘어, 인지 건강의 조기 신호까지 포착하는 안전망으로 발전할 수 있는 기술적 토대가 됩니다. 병원을 찾아 정밀 검사를 받기까지의 문턱은 여전히 높은데요. 그보다 앞서 전화 속 일상 대화에서 조기 신호를 발견하고, 필요한 분들이 더 빨리 전문 진료로 연결되도록 돕는 것이 목표입니다.
이미 첫걸음도 떼었습니다. 네이버클라우드는 치매 디지털 솔루션 스타트업 (주) 이모코그와 함께 서울특별시보라매병원에서 전화로 인지검사를 수행하는 임상연구를 진행하고 있습니다. CareCall의 전화 한 통으로 인지 건강을 살필 수 있는 날을 한 걸음씩 앞당기고 있습니다.
짧은 안부 전화가 어르신의 건강을 지키는 첫 번째 안전망이 되는 것. 네이버클라우드가 음성 AI 기술로 만들어 가고자 하는 미래입니다.
※ 이 글에서 소개한 두 연구는 연구 단계의 결과이며, 의료진의 진단을 대체하지 않습니다.
논문 정보
Listening Between the Lines: Joint Learning of ASR Embeddings and LLM-Augmented Linguistics for Dementia Detection
Olivier Jiyoun Jung, Jonghyeon Park, Myungwoo Oh
https://arxiv.org/abs/2606.30675
LoRA-Tuned Large Language Models for Dementia Detection via Multi-View Speech-Derived Features
Jonghyeon Park, Olivier Jiyoun Jung, Myungwoo Oh
https://arxiv.org/abs/2606.28445